لقد احتجت مؤخراً إلى إيجاد أفضل مولد صوت أنثوي يعمل بالذكاء الاصطناعي لمشروع FixThePhoto ، وسرعان ما أدركت أن الأصوات الطبيعية ليست الشيء الوحيد المهم.
في مشروعنا FixThePhoto ، احتجتُ إلى صوت أنثوي مُولّد بالذكاء الاصطناعي للدروس التعليمية، والفيديوهات الترويجية، ومنشورات وسائل التواصل الاجتماعي القصيرة. أردنا تجنّب تسجيل كل نص بأنفسنا، لكن إيجاد صوت مناسب لمختلف الصيغ كان أصعب مما توقعت. كان لا بدّ أن يبدو طبيعيًا ومعبرًا، لا كالكلام المُولّد بالحاسوب المعتاد.
عند مقارنة الأدوات، لم أكتفِ بالنظر إلى مدى جمال الأصوات فحسب، بل ركزتُ اهتمامي على وضوح النطق، وفترات التوقف الطبيعية، وتغيرات النبرة، ومدى قدرة كل صوت على نقل المشاعر. كان هذا الأمر بالغ الأهمية لأن نصوصنا تراوحت بين تعليمات بسيطة خطوة بخطوة ومحتوى ترويجي أكثر حيوية.
قارنتُ أيضًا نطاق الأصوات واللهجات واللغات المتاحة، وخيارات التحرير، وجودة الصوت، وسرعة كل أداة في توليد الصوت. وتحققتُ من إمكانية التحكم في الأداء، مثل النبرة وسرعة الكلام. ولأن التسجيلات كانت مُخصصة لمشاريع FixThePhoto الاحترافية، فقد بحثتُ أيضًا في تراخيص الاستخدام التجاري، والأسعار، وسهولة حفظ ملفات الصوت النهائية.
في الاختبار، استخدمتُ نفس النصوص مع كل مولد صوت أنثوي لضمان عدالة المقارنة. شملت المجموعة شرحًا موجزًا لكيفية الاستخدام، ومقدمة عن المنتج، ومنشورًا بسيطًا على وسائل التواصل الاجتماعي، ومقطعًا أطول يتضمن أرقامًا ومصطلحات تقنية. ساعدني هذا في معرفة مدى ملاءمة كل صوت لأنواع المحتوى المختلفة.
انتبهتُ جيدًا لكيفية تعامل كل صوت مع النطق والتنفس والتوقفات وتغييرات النبرة. وعند الإمكان، شغّلتُ النص نفسه عدة مرات للتأكد من ثبات النتائج. سهّل هذا الأمر تحديد الأدوات التي تُقدّم نتائج موثوقة بدلًا من الحصول على تسجيل واحد جيد بشكل استثنائي.
بالتعاون مع زملائي من فريق FixThePhoto، اخترنا بعضًا من أشهر الأدوات لإنشاء أصوات نسائية بتقنية الذكاء الاصطناعي. وبمجرد أن وضعنا معاييرنا وخطة الاختبار، بدأنا العمل فورًا، لنتمكن من مقارنة الخيارات دون إضاعة الوقت.
ابدأ بنص واضح. احذف الرموز غير الضرورية، وتجنب الاختصارات غير المألوفة، واجعل الجمل قصيرة وسهلة النطق. يجب أن يبدو النص طبيعياً عند التحدث به.
اختر النبرة المناسبة للمحتوى. فالنبرة الهادئة والمطمئنة تناسب مقاطع الفيديو التعليمية، بينما يمكن أن تجعل النبرة الحيوية الإعلانات والمنشورات القصيرة أكثر جاذبية.
استخدم علامات الترقيم للتحكم في أسلوب الكلام. فاستخدام علامات الترقيم والمسافات يُحسّن من سلاسة الصوت. أضف فواصل حول الكلمات التقنية أو النقاط الرئيسية عندما يدعم البرنامج ذلك.
اضبط السرعة ودرجة الصوت بعناية. قم بإجراء تعديلات طفيفة بدلاً من تغيير كل شيء دفعة واحدة. أنصحك بالاحتفاظ بالصوت الأصلي أولاً، ثم تعديله تدريجياً حتى تحصل على النتيجة المطلوبة.
أضف لمسة عاطفية وتأكيداً. إذا كان مولد صوت بالذكاء الاصطناعي يسمح لك بتعديل المشاعر أو أسلوب الأداء، فجرّب خيارات مختلفة بدلاً من إبقاء الصوت رتيباً. كما أن التركيز على الكلمات الرئيسية يُضفي حيوية على الإعلانات والمحتوى غير الرسمي.
اختبر الكلمات الصعبة بشكل منفصل. غالبًا ما تواجه أصوات الذكاء الاصطناعي صعوبة في نطق الأرقام، والأسماء العلمية، والمصطلحات المختصرة، وأسماء الشركات، والكلمات الخاصة بمجالات معينة. اختبر بضعة أسطر أولًا وصحح أي أخطاء في النطق قبل إنشاء المقطع الصوتي الكامل.
أنشئ عدة نسخ. حتى مع استخدام نفس الإعدادات، قد تختلف النتائج قليلاً في السرعة والنبرة. عادةً ما أنشئ عدة نسخ، وأقارنها، وأختار النسخة التي تبدو أكثر طبيعية.
"ابتكري صوتاً أنثوياً واضحاً وواثقاً للدروس التعليمية والمحتوى التثقيفي. حافظي على أسلوب ودود وطبيعي وسهل المتابعة، مع وتيرة ثابتة وفترات توقف سلسة ولمسة من العاطفة. تجنبي الصوت الرتيب أو الآلي أو المبالغ فيه."
صوت أنثوي دافئ وودود، يوحي بحديث وديّ. حافظي على نبرة صوت ناعمة ولطيفة، مع أنفاس طبيعية، ونبرة صوت سلسة، وتشديد خفيف على الكلمات المهمة. يجب أن يبدو الصوت حقيقياً وجذاباً، وليس كالكلام المُولّد آلياً.
صوت أنثوي حيوي وواثق للإعلانات والمحتوى الترويجي. حافظي على أسلوب أداء مفعم بالحيوية والإقناع، مع نبرة معبرة، وتغييرات طبيعية في السرعة، وتأكيد إضافي على العبارات الرئيسية. اجعليه جذاباً للانتباه دون أن يبدو متطفلاً أو مبالغاً فيه.
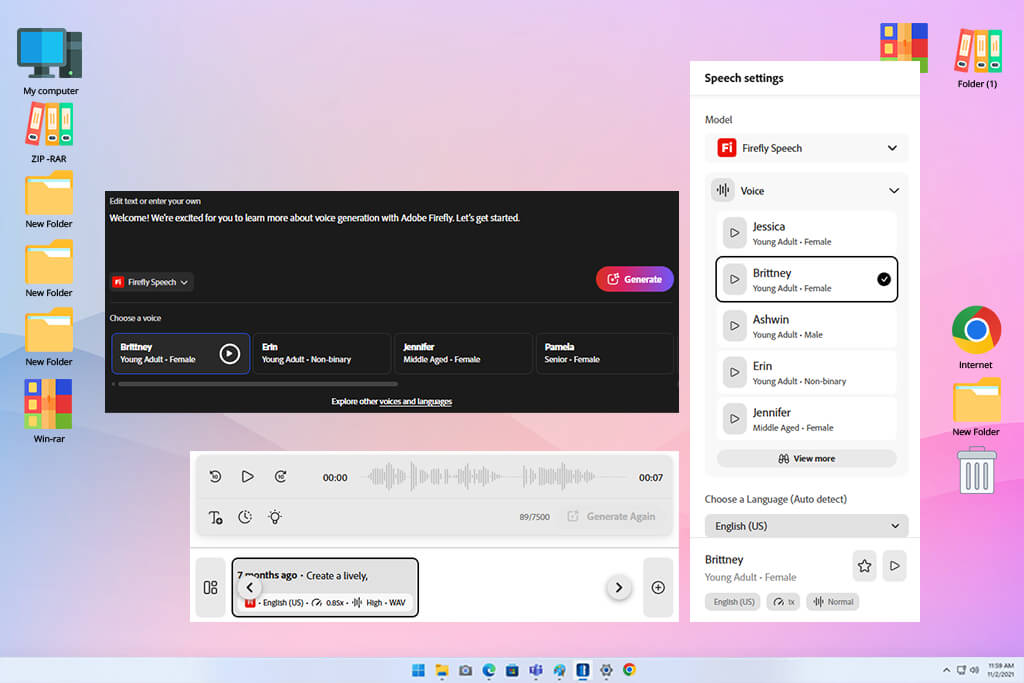
بدأتُ باستخدام Adobe Firefly لأختبر قدرته على توفير صوت أنثوي احترافي لفيديوهات FixThePhoto دون تعقيد العملية. استخدمتُ نفس النصوص التعليمية والترويجية في Generate Speech ، وجرّبتُ عدة أصوات نسائية، وقارنتُ بين نطقها، وفواصلها، ونبرتها، وأدائها العام.
أول ما أعجبني هو سهولة تعديل الصوت. يتيح لك Firefly تغيير السرعة، ودرجة الصوت، وفترات التوقف، والنطق، والنبرة. بل يمكنك حتى تعديل كلمات أو عبارات معينة دون الحاجة إلى إعادة تشغيل النص بالكامل.
أعجبتني أيضًا تشكيلة الأصوات النسائية المتنوعة التي يوفرها مولد الأصوات النسائية هذا بتقنية الذكاء الاصطناعي. فبدلًا من الحصول على صوت اصطناعي نمطي واحد، يُمكنني الاختيار من بين أعمار وأنماط مختلفة. كما تتضمن مساحة عمل الكلام في Firefly أصواتًا مُساعدة مثل ElevenLabs Multilingual v2، مما يمنحني خيارات أكثر.
سهّل هذا الأمر اختيار صوت مناسب لكل نوع من أنواع الفيديوهات، بدءًا من الدروس التعليمية الهادئة وصولًا إلى المحتوى الترويجي المفعم بالحيوية. كما جرّبتُ عدة لغات لأن محتوى FixThePhoto موجّه لجمهور دولي. يدعم Firefly أكثر من 20 لغة ويُقدّم خيارات لهجات متعددة.
"لقد اختبرت بعض الأصوات النسائية في مقطع فيديو قصير وأعجبتني مدى طبيعية صوتها. كان الأداء واضحًا، لكن كان عليّ تعديل بعض الجمل للحصول على النبرة المناسبة تمامًا."
كانت الميزة الأكثر فائدة بالنسبة لي هي القدرة على ضبط الكلمات والعبارات بدقة. فإذا لم يكن مصطلح تقني ما مناسبًا تمامًا، كان بإمكاني تعديل ذلك الجزء فقط بدلًا من البدء من جديد. كما كان بإمكاني إضافة بعض المشاعر أو التوقفات لجعل الأداء يبدو أكثر طبيعية.
أعجبني أيضاً إمكانية معاينة النتيجة قبل تصدير الصوت كملف WAV. بعد ذلك، تمكنت من استخدامه بسهولة في تطبيقات أدوبي المجانية الأخرى، مثل Premiere Pro أو After Effects. هذا جعل Firefly يبدو جزءاً من عملية تحرير شاملة، وليس مجرد مولد أصوات أنثوية بسيط يعمل بالذكاء الاصطناعي.
ما لفت انتباهي هو كفاءة Firefly في التعامل مع التعليق الصوتي العادي. بعد تجربة نصوص مختلفة، وجدتُ أنه يُناسب بشكل أفضل التعليق الصوتي النسائي الواضح والمتقن مقارنةً بالأصوات ذات الطابع التمثيلي. كانت أدوات التحكم في درجة الصوت وسرعته ونطقه مفيدة، كما أن دعمه للغات المختلفة وتطبيقات Adobe سهّل العملية برمتها. عمومًا، حصلتُ على قدر كبير من التحكم دون الحاجة إلى التعامل مع إعدادات معقدة.
بالنسبة للمشاريع الاحترافية، أوليتُ اهتمامًا كبيرًا لحقوق الاستخدام. تُشير أدوبي إلى أن الكلام المُنشأ باستخدام نماذج Firefly Speech آمن للاستخدام التجاري. وبما أنني كنت أعمل على دروس تعليمية، وفيديوهات ترويجية، ومحتوى تعليمي، فقد كان هذا سببًا إضافيًا لتفضيل Firefly كأحد أفضل الخيارات المتاحة.
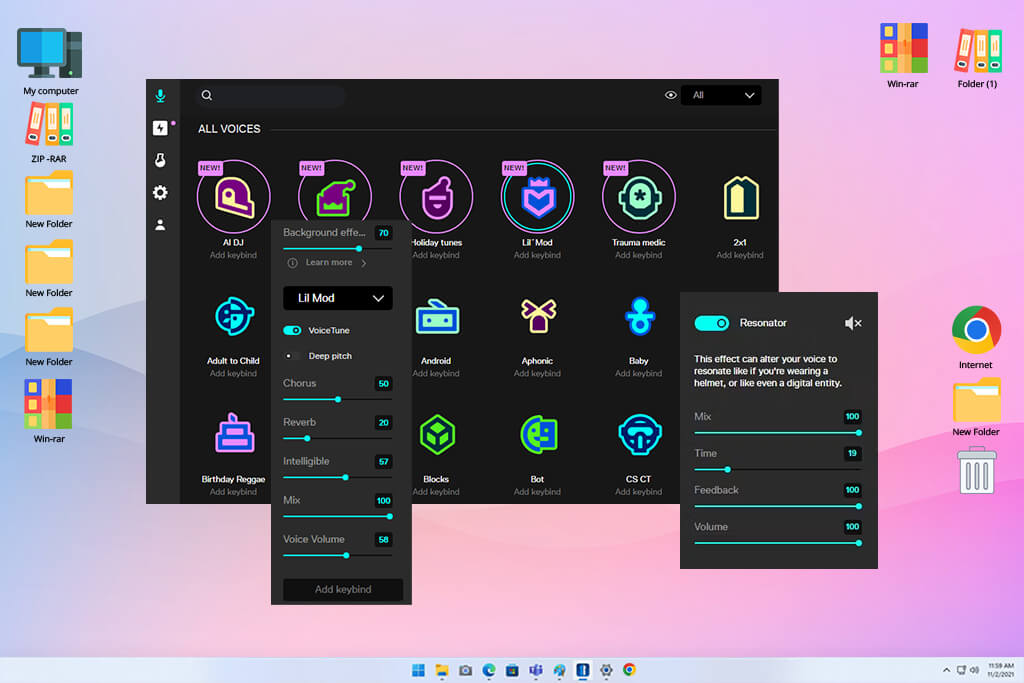
كان Voicemod مختلفًا بعض الشيء عن مولدات الصوت الأنثوية الأخرى التي تعمل بالذكاء الاصطناعي والتي جربتها، لأنه يُغير صوتك أثناء التحدث بدلًا من تحويل النص إلى سرد. قرأتُ نفس الجمل القصيرة التي استخدمتها مع المولدات الأخرى، واستمعتُ إلى كيفية تغيير كل صوت من أصوات الذكاء الاصطناعي لتسجيلي. ثم قارنتُ النتائج بصوتي الأصلي لأرى مدى طبيعية التغييرات.
ما لاحظته فوراً هو أن Voicemod يُغيّر الصوت نفسه، بدلاً من مجرد إضافة تأثير أساسي. ولأن التغييرات تحدث أثناء الكلام، فهو مناسب تماماً للمحتوى المباشر كالبث المباشر والمحادثات والعروض التقديمية، حيث يُفضّل الحفاظ على إيقاعك الطبيعي وطاقتك.
بالنسبة للأصوات النسائية، جربتُ عدة خيارات لأنماط الشخصيات بدلاً من الاقتصار على السرد التقليدي. يتضمن مولد اللهجات بالذكاء الاصطناعي أكثر من 200 صوت، كما يُمكنني استخدام برنامج Voicelab لإنشاء الأصوات أو تعديلها. توجد أيضاً خيارات إضافية مُشاركة من قِبل المُستخدمين، مما أتاح لي المزيد من الأصوات للتجربة.
وجدتُ أنه أنسب للمحتوى الإبداعي من التعليق الصوتي ذي الطابع التجاري. فقد أتاح لي تجربة شخصيات وأصوات مختلفة لمعرفة الأنسب. وبحسب الصوت، كان بإمكاني أيضاً تعديل طبقة الصوت، والصدى، والسرعة.
لاحظتُ أن جودة التسجيل أحدثت فرقًا ملحوظًا. يعمل Voicemod بأفضل شكل عند التحدث بوضوح وتقليل الضوضاء المحيطة إلى أدنى حد. كما حققتُ أفضل النتائج باستخدام اللغة الإنجليزية، وهذا منطقي لأن الذكاء الاصطناعي دُرِّب بشكل أساسي على أصوات متحدثين محترفين باللغة الإنجليزية. اختبرتُ تسجيلًا واضحًا وآخر أكثر عفوية، وكان التسجيل الواضح أفضل بكثير بعد تغيير الصوت.
في مشاريعي المتعلقة ببرنامج FixThePhoto ، كنت أختار Voicemod عندما يكون لديّ تسجيل صوتي طبيعي وأرغب في تغيير نبرة الصوت. لم يكن خياري الأول عندما كنت بحاجة إلى تحويل نص مكتوب إلى تعليق صوتي كامل.
بشكل عام، وجدتُ Voicemod مفيدًا للغاية عندما أردتُ تغيير صوتي دون فقدان أسلوبي الطبيعي في الكلام. وقد كان أداؤه ممتازًا بشكل خاص في التواصل المباشر، والبث المباشر، والألعاب، والمحتوى الذي يعتمد على الشخصيات. وبالمقارنة مع أدوات تحويل النص إلى كلام التقليدية، فقد منحني أيضًا مساحة أكبر لتجربة أصوات وأساليب مختلفة.
لن أفضّله لكتابة نصوص تعليمية طويلة بدلاً من أداة تحويل النص إلى كلام متخصصة. لكنه مناسب تماماً للفيديوهات القصيرة على مواقع التواصل الاجتماعي. فميزة تغيير الصوت في الوقت الفعلي تُسهّل عليك الحفاظ على أسلوبك الخاص في الكلام مع إضافة لمسة شخصية مميزة للمحتوى.
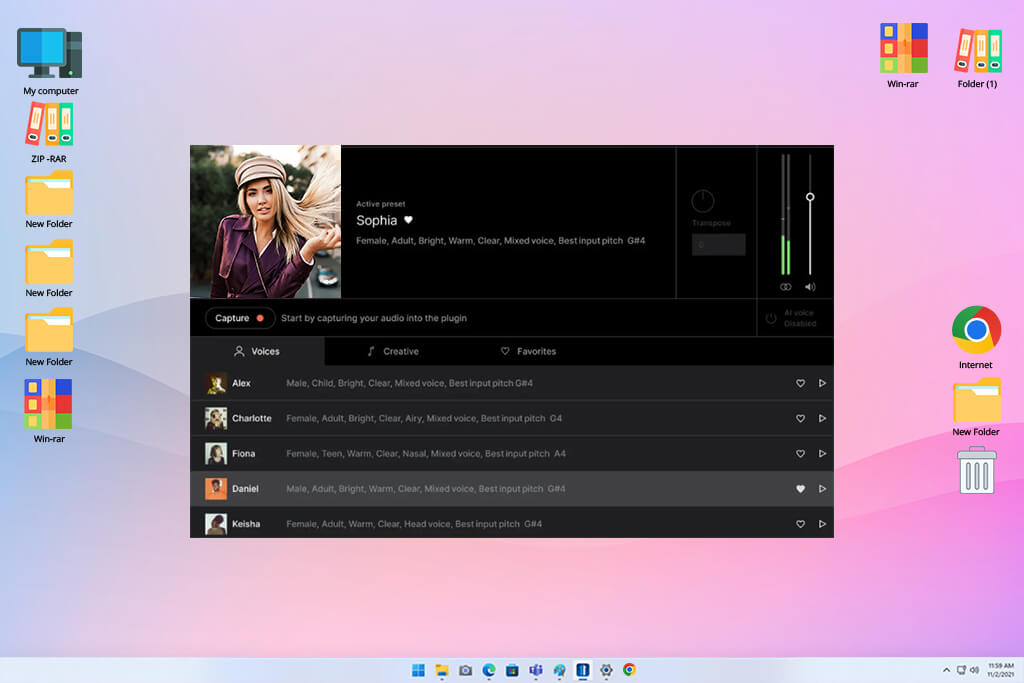
كانت VoiceAI مثيرة للاهتمام لأنها قادرة على تغيير الصوت الموجود بدلاً من مجرد تحويل النص إلى كلام. جربتُ كلاً من مُغيّر الصوت المباشر وأدوات الصوت عبر الإنترنت، باستخدام نفس العبارات القصيرة كما في المولدات الأخرى.
يُتيح لي مصمم أصوات يعمل بالذكاء الاصطناعي الوصول إلى آلاف الأصوات في Voice Universe، بما في ذلك أصوات نسائية أنشأها مستخدمون آخرون. كما يُمكنني إنشاء أصوات جديدة أو استنساخ أصوات موجودة. مع هذا الكم الهائل من الخيارات المتاحة، يُوفر لي حرية أكبر بكثير من مُغيرات الصوت التقليدية.
بدأتُ باستخدام صوت أنثوي من المكتبة الصوتية، واستخدمته في تسجيل واضح. ثم غيّرتُ طبقة الصوت وجرّبتُ صوتًا آخر لمقارنة النتائج. ما أعجبني في Voice.ai هو أنه حافظ على التوقيت وجزء كبير من الأداء الأصلي، بدلًا من البدء من الصفر بنص مكتوب.
يتيح لك المحول عبر الإنترنت أيضًا تحميل ملف MP3 أو WAV قصير، واختيار صوت، وتعديل درجة الصوت، وتحويله مباشرةً في المتصفح. وهذا يجعله مفيدًا لاختبار أصوات مختلفة بسرعة مع ملفات صوتية موجودة.
"كان خيار الصوت الأنثوي مناسبًا للمكالمات، وكان التبديل بين الأصوات سريعًا. بدا بعضها غير طبيعي، لذلك جربت عدة أصوات قبل أن أجد صوتًا يعطي كلامي نتيجة مقنعة."
أكثر ما أعجبني هو موقع Voice Universe. كان هناك عدد هائل من الأصوات للاختيار من بينها، بما في ذلك أصوات من صنع مستخدمين آخرين. كان من السهل تجربة أصوات نسائية مختلفة واختيار الصوت المناسب لنوع المحتوى الذي كنت أعمل عليه.
تتيح لك VoiceAI أيضًا إنشاء صوت من عينة صوتية. وكانت ميزة الاستنساخ مفيدة عندما احتجت إلى صوت ذي نبرة أكثر تحديدًا بدلًا من صوت الراوية الشابة النمطية.
أفضّل استخدام مولد الصوت الأنثوي هذا عندما يكون لديّ تسجيل جاهز للعمل عليه أو عندما أحتاج إلى تغيير صوت شخص ما مباشرةً، بدلاً من إنشاء تعليق صوتي طويل من نص مكتوب. وقد كان فعالاً للغاية مع أصوات الشخصيات النسائية، ومقاطع الفيديو على وسائل التواصل الاجتماعي، والبث المباشر، والمحادثات العادية.
كما أنه يعمل في الوقت الفعلي مع تطبيقات مثل ديسكورد وزووم والألعاب ومنصات التواصل الأخرى، لذا فهو يقدم أكثر من مجرد أداة تحويل النص إلى كلام أساسية. مع ذلك، بالنسبة لدروس FixThePhoto الاحترافية، فضّلتُ أدوات تحويل النص إلى كلام العادية لأنها تمنحني تحكمًا أفضل في النص.
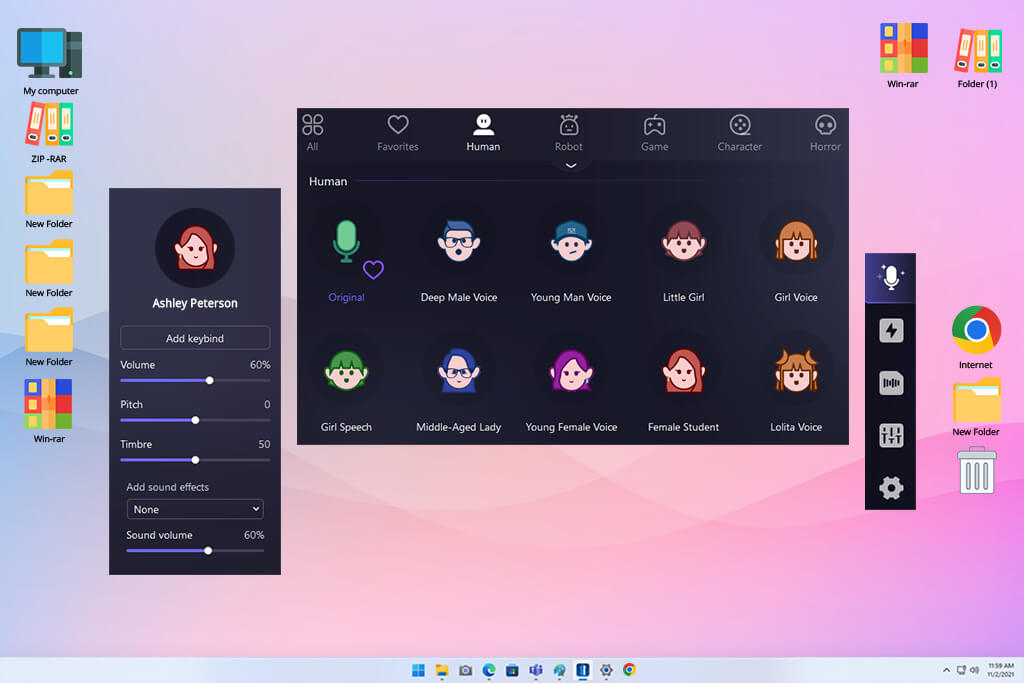
اختبرتُ EaseUS VoiceWave كمُغيّر للصوت أكثر من كونه مُولّداً صوتياً أنثوياً بالذكاء الاصطناعي. فبدلاً من إدخال النصوص فقط، سجّلتُ مقاطع صوتية قصيرة وجرّبتُ مؤثرات صوتية أنثوية مختلفة أثناء التحدث.
يدعم برنامج VoiceWave أكثر من 100 مؤثر لتغيير الصوت في الوقت الفعلي ، كما يمكنه تعديل ملفات الفيديو والصوت المسجلة مسبقًا. هذا سهّل عليّ مقارنة التحولات المختلفة للصوت الأنثوي دون الحاجة إلى إعداد عملية تحرير صوتية معقدة.
أعجبني في هذا التطبيق إمكانية تسجيل صوتي وتعديله في نفس الوقت. استطعت ضبط طبقة الصوت وسرعته، وحفظ النتيجة بصيغة MP3، واستخدام تقنية تقليل الضوضاء المدعومة بالذكاء الاصطناعي لتنقية التسجيلات من الضوضاء الخلفية. بالنسبة للمقاطع القصيرة على مواقع التواصل الاجتماعي والتعليقات الصوتية العفوية، فإن وجود كل هذه الأدوات في مكان واحد جعل العملية أسرع بكثير.
جربتُ أيضًا لوحة الصوت، مما جعل استخدام VoiceWave مختلفًا تمامًا عن أدوات مثل Firefly أو ElevenLabs. يحتوي على مئات من الإعدادات الصوتية والمؤثرات، مما مكّنني من إضافة أصوات إضافية إلى صوت أنثوي وتجربة تركيبات مختلفة لمحتوى أكثر مرحًا.
لن أختار هذه التأثيرات لشرحٍ جادٍّ لبرنامج FixThePhoto ، لكنها قد تكون مناسبةً لمنشورات مواقع التواصل الاجتماعي، أو فيديوهات الألعاب، أو الصور المضحكة، أو لمجرد تجربة شيءٍ مختلف. وبما أن البرنامج مصممٌ أساسًا لنظام ويندوز ولتغييرات الصوت المباشرة، فإن هذا يحدّ من استخداماتي له.
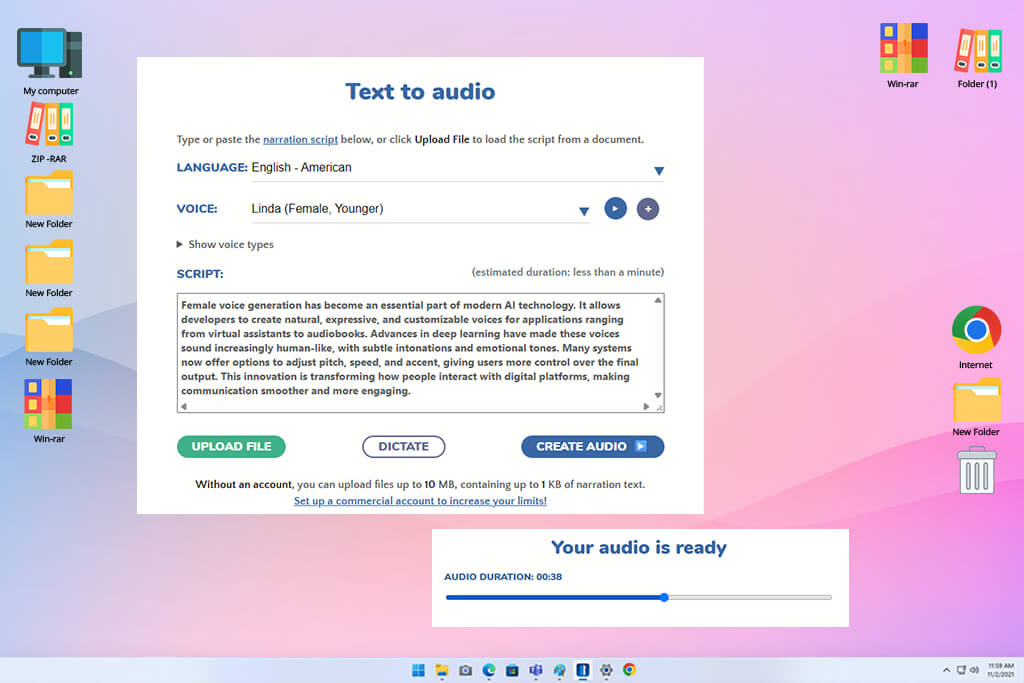
كان استخدام تطبيق Narakeet سهلاً للغاية. كل ما فعلته هو لصق النص، واختيار صوت، والاستماع إليه، ثم تجربة صوت آخر إذا لم يعجبني. اختبرت نفس النصوص التعليمية، ومقدمات المنتجات، ومنشورات التواصل الاجتماعي، والنصوص التقنية كما فعلت مع الأدوات الأخرى. ساعدني هذا في معرفة الأصوات النسائية المناسبة للأرقام، والمصطلحات التقنية، والجمل الطويلة بسرعة.
كان التنوع الكبير في الأصوات من أكثر الأمور التي أعجبتني في مولد الأصوات الأنثوية الواقعي هذا بتقنية الذكاء الاصطناعي. فهو يضم أكثر من 900 صوت بأكثر من 100 لغة، مما أتاح لي خيارات واسعة من الأصوات النسائية للاختيار من بينها ومقارنتها.
لم أختر أول صوت أعجبني لمجرد أن بعض الأصوات تنطق كلمات معينة بشكل أفضل من غيرها. بل إن مولد المؤثرات الصوتية بالذكاء الاصطناعي نفسه يوصي بتجربة عدة خيارات، خاصةً عند التعامل مع المصطلحات التقنية أو أسماء العلامات التجارية أو النطق غير المألوف. وهذا ما لاحظته أثناء الاختبار.
"استخدمته لإنشاء تعليق صوتي أنثوي لدرس تعليمي. كان استخدامه سهلاً، وخرجت الكلمات بوضوح في معظم الأحيان. الشيء الوحيد الذي كان ينقصه هو المزيد من الإحساس في الصوت."
أعجبني أيضاً أن Narakeet يمنحني تحكماً أكبر في النص نفسه بدلاً من مجرد تغيير إعدادات الصوت. إذ يُمكنني استخدام توجيهات المسرح لتغيير الأصوات، وتعديل النطق، أو إنشاء حوار. كما توجد أيضاً أدوات تحكم منفصلة لسرعة الكلام ومستوى الصوت.
جربتُ أيضًا فترات التوقف وسرعات القراءة المختلفة، إذ أن حتى التغييرات الطفيفة في الإيقاع قد تجعل صوت المرأة يبدو أكثر طبيعية أو تُغير أسلوب أدائها تمامًا. بالنسبة للنصوص الطويلة، أعجبني إمكانية تحميل ملف Word أو ملف نصي بدلًا من لصق النص كاملًا في المحرر.
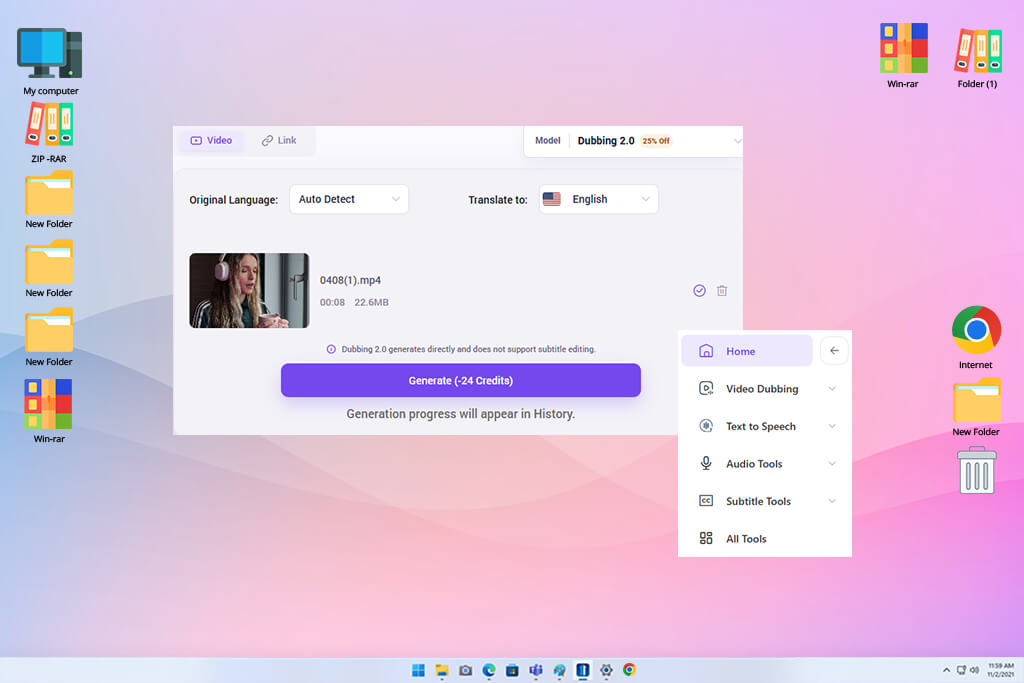
اختبرتُ AI Dubbing بطريقة مختلفة قليلاً، لأنها تعمل مع مقاطع الفيديو الموجودة بدلاً من إنشاء تعليق صوتي من نص. حمّلتُ مقطع فيديو قصيرًا لشخص يتحدث، واخترتُ لغة أخرى، وقارنتُ النسخة المدبلجة بالنسخة الأصلية لأرى مدى طبيعية الصوت.
كانت العملية بسيطة: حمّلتُ الفيديو، واخترتُ اللغة، وتركتُ الأداة تتولى عملية الدبلجة. أردتُ أن أرى ما إذا كان الصوت الأنثوي الجديد سيحافظ على توقيت المتحدثة الأصلية ويبدو كأنه صوتها، بدلاً من أن يتحول إلى تعليق صوتي عام.
أكثر ما أعجبني هو الحفاظ على جودة الصوت. فالنسخة المترجمة التي يقدمها برنامج دبلجة الذكاء الاصطناعي تحافظ على خصائص صوت المتحدث وتتبع حركات فمه، مما يجعلها أقرب بكثير إلى التسجيل الأصلي.
في تجاربي، كان هذا الأمر أهم من امتلاك مكتبة ضخمة من الأصوات النسائية. تمثلت الفائدة الرئيسية في القدرة على تعديل فيديو موجود ليناسب جمهورًا جديدًا دون الحاجة إلى مطالبة المُقدّم بإعادة تسجيله بالكامل. وجدتُ هذا مفيدًا للغاية للدروس التعليمية، والفيديوهات التعليمية، ومنشورات وسائل التواصل الاجتماعي التي يجب نشرها بلغات متعددة.
لقد بحثتُ أيضاً في مدى ملاءمة هذا الإعداد لسير عمل المحتوى الاحترافي. فبدلاً من التعامل مع النص واختيار الصوت والتسجيل والمزامنة كخطوات منفصلة، تجمع الأداة بين الترجمة ومسار الصوت الجديد في عملية واحدة.
هذا يعني أيضاً تقليل أعمال التحرير في المشاريع متعددة اللغات. مع ذلك، أنصح بالتحقق من حدود الخطة وطول الفيديو أولاً، لأن ذلك قد يؤثر على ما يمكنك استخدامه وكمية المحتوى الذي يمكنك معالجته.
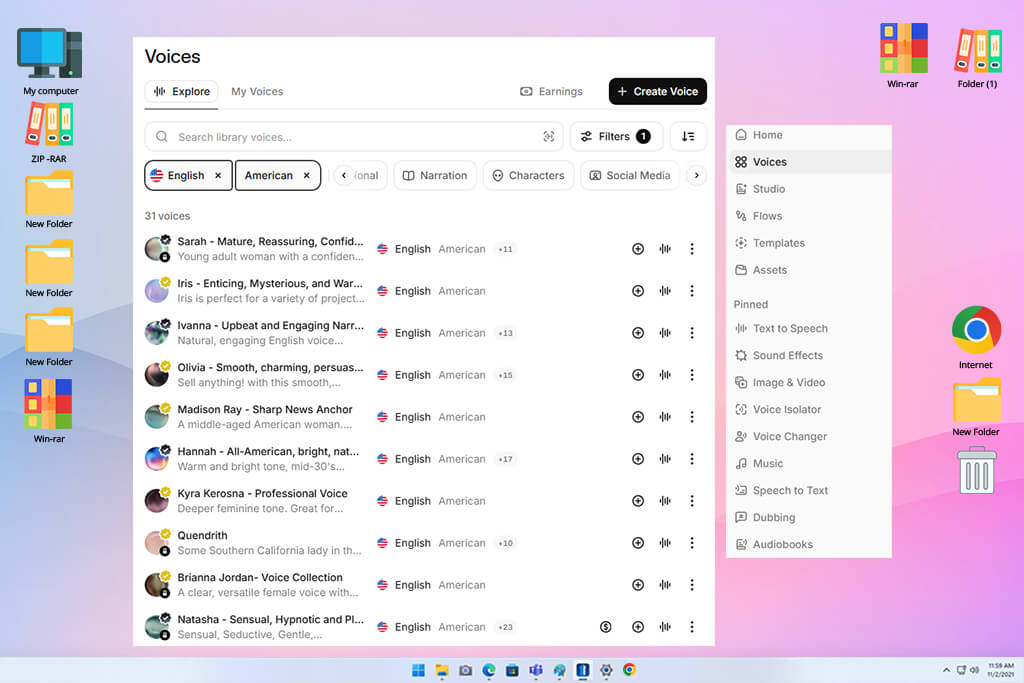
كان ElevenLabs أحد مولدات الأصوات الأنثوية بالذكاء الاصطناعي التي قضيت معها وقتًا طويلاً. أردتُ أن أرى مدى قدرة أصواته الأنثوية على التعامل مع أنواع مختلفة من المحتوى، لذا اختبرتُ النصوص نفسها عبر خيارات متعددة. بدت بعض الأصوات أكثر طبيعية من غيرها، خاصةً عندما تضمن النص مشاعر أو أرقامًا أو مصطلحات تقنية.
جربتُ أيضًا أساليب كلام مختلفة، من صوت هادئ للدروس التعليمية إلى صوت أكثر حيوية للمحتوى الترويجي. يوفر برنامج استنساخ الصوت بالذكاء الاصطناعي أدوات تحويل النص إلى كلام للويب والهواتف المحمولة، بالإضافة إلى واجهات برمجة التطبيقات (APIs) ومجموعات تطوير البرامج (SDKs)، والتي قد تكون مفيدة إذا دعت الحاجة إلى أتمتة سير العمل لاحقًا.
قضيتُ أيضًا بعض الوقت في اختبار تخصيص الصوت. توفر ElevenLabs مجموعة كبيرة من الأصوات، واستطعتُ استخدام خاصية استنساخ الصوت الفوري لإنشاء نسخة رقمية من صوت معين انطلاقًا من عينة صوتية قصيرة. وقد أتاح لي ذلك العمل مع صوت محدد بدلًا من الاقتصار على الاختيار من بين الخيارات المتاحة فقط.
يُعدّ التناسق مفيدًا للغاية عند إنشاء فيديوهات متعددة. فاستخدام الراوية نفسها في مشاريع مختلفة يُساعد على بناء صوت مألوف لموقع إلكتروني أو قناة YouTube أو سلسلة تعليمية.
"كان صوت الأنثى مناسباً جداً للسرد الطويل، وبدا أكثر تعبيراً مما توقعت. كان طبيعياً بشكل عام، على الرغم من أنني اضطررت إلى تصحيح بعض الكلمات التي نُطقت بشكل خاطئ."
جربتُ أيضًا ElevenLabs للعمل متعدد اللغات، نظرًا لأن محتوى FixThePhoto قد يحتاج إلى أن يكون متاحًا بلغات مختلفة. تتيح ميزة الدبلجة فيه ترجمة الصوت والفيديو إلى أكثر من 90 لغة مع الحفاظ على مشاعر المتحدث وتوقيته ونبرته وهويته.
كانت ميزة الدبلجة v2 من أبرز الميزات التي اختبرتها، لأنها تعمل انطلاقًا من التسجيل الأصلي، وليس فقط من النص المكتوب. فهي تتولى الترجمة، واستنساخ الصوت، والدبلجة، والتوقيت تلقائيًا، مع الحفاظ على روح الأداء الأصلي. وهذا ما جعل النتيجة مختلفة تمامًا عن التعليق الصوتي الأنثوي المترجم القياسي.
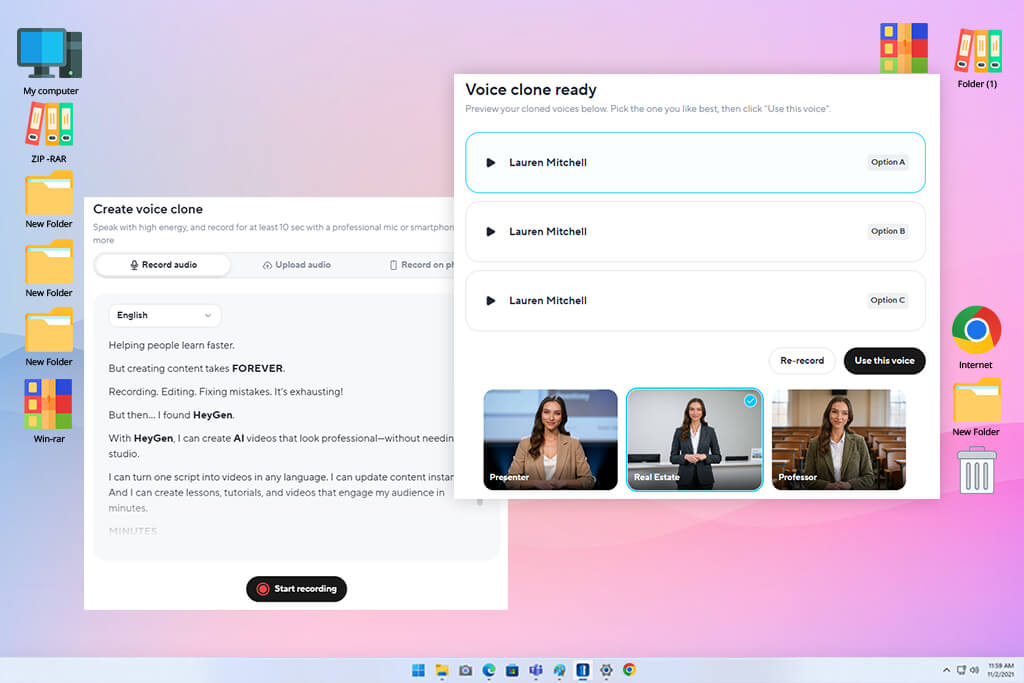
اختبرتُ HeyGen كجزء من سير عمل الفيديو بدلاً من استخدامه فقط لتوليد الصوت. أنشأتُ بعض النصوص القصيرة وجرّبتُ أصواتًا نسائية مختلفة مع نصوص ترويجية وتعليمية وحوارية.
تتيح لي هذه الأداة الإلكترونية لتوليد أصوات نسائية تعديل النبرة والسرعة والتشديد والتنغيم، مما يسمح لي بضبط أداء كل جملة بدقة بدلاً من استخدام نفس الصوت طوال الوقت. وقد كان هذا مفيدًا عندما احتجت إلى صوت أنثوي أكثر حيوية لإعلان، وصوت أكثر هدوءًا لدرس تعليمي.
كانت ميزة استنساخ الصوت من بين الميزات الأخرى التي أردت تجربتها. يستطيع HeyGen إنشاء نسخة صوتية من عينة صوتية قصيرة واستخدامها كراوٍ واحد في مقاطع الفيديو والدورات التدريبية والبودكاست. بدا هذا مفيدًا لسير عمل FixThePhoto ، حيث يُضفي استخدام صوت واحد طوال السلسلة مزيدًا من التناسق على المحتوى. فبدلًا من استخدام صوت أنثوي مختلف مُولّد بالذكاء الاصطناعي لكل مشروع، يُمكنني اختيار صوت واحد مألوف واستخدامه مجددًا في عدة مقاطع فيديو.
ما ميّز HeyGen هو مدى ارتباط ميزات الصوت فيه بعملية إنشاء الفيديو. إذ يُمكنني إضافة الصوت المُولّد مباشرةً إلى محرر فيديو بالذكاء الاصطناعي ، إلى جانب العناصر المرئية والترجمة وغيرها. هذا يعني أنني لم أكن مضطرًا للتنقل بين العديد من الأدوات المختلفة أثناء تجميع الفيديو.
اختبرتُ أيضاً ميزة الدبلجة متعددة اللغات، التي تدعم أكثر من 177 لغة ولهجة، بما في ذلك الدبلجة بالذكاء الاصطناعي ومزامنة حركة الشفاه. بالنسبة للحملات الدولية، فإن القدرة على ترجمة المحتوى، وإنشاء الصوت الجديد، ومزامنته مع الفيديو في نفس المكان، تُسرّع العملية برمتها بشكل ملحوظ.
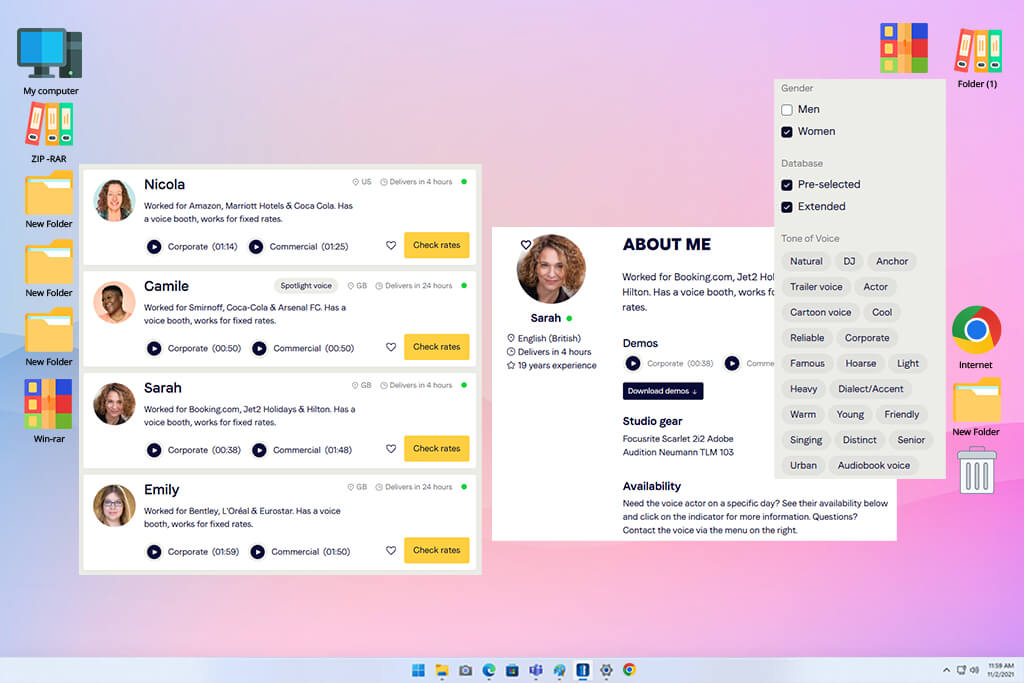
تميزت Voicebooking بأنها توفر تجربة عملية أكثر في مجال التعليق الصوتي. استخدمتُ مولد الأصوات المدعوم بالذكاء الاصطناعي المجاني لإضافة نصوصي، وتجربة أصوات مختلفة، ومعرفة أيها الأنسب من حيث الإيقاع والجو العام.
تضم المنصة أكثر من 575 صوتًا بأكثر من 55 لغة، بما في ذلك خيارات صوتية نسائية ورجالية. هذا التنوع الكبير في الخيارات سهّل تجربة العديد من الأصوات والعثور على الصوت المناسب لكل فيديو.
بحثتُ أيضًا في مدى إمكانية تغيير نبرة الصوت. توفر باقات Voicebooking المدفوعة خياراتٍ للتوقفات والتشديد، مما ساهم في جعل القراءة أكثر حيوية. اختبرتُ النص الترويجي نفسه مع هذه الإعدادات وبدونها، ووجدتُ أن حتى التغييرات الطفيفة في التوقفات تُحسّن الأداء. كما توجد مؤثرات تُسهّل إضافة المزيد من التشديد دون الحاجة إلى تعديل كل سطر يدويًا.
"كنت أرغب في صوت أنثوي أكثر احترافية لمشروع ما، لذا كان وجود عدة خيارات للاختيار من بينها مفيداً. كانت الجودة أفضل بشكل ملحوظ من أصوات الذكاء الاصطناعي الأساسية التي جربتها، على الرغم من أنها استغرقت وقتاً أطول قليلاً من استخدام أداة مؤتمتة بالكامل."
أضفتُ أيضًا Voicebooking لأنها تتيح لك اختبار نصوص التعليق الصوتي قبل بدء الإنتاج. صُممت هذه الأداة للتحقق من التوقيت impact في مقاطع الفيديو والمشاريع التجريبية ولوحات القصة، وهو ما يتوافق مع أحد أهم الأمور التي أردتُ التحقق منها أثناء تقييم FixThePhoto.
تتيح لك النسخة المجانية أيضًا تجربة الأصوات من المكتبة في مشروعك الأول، ولكنها تأتي مع قيود على عدد الأحرف والمشاريع والتنزيلات. وقد سهّل ذلك التحقق مما إذا كان النص طويلًا جدًا، وما إذا كان صوت الأنثى مناسبًا للموضوع، وما إذا كان الإيقاع مناسبًا.
بدأنا بدرس تعليمي قصير لتحرير الصور، واختبرنا كيفية تعامل كل صوت مع التعليمات والأرقام وأسماء البرامج والمصطلحات التقنية. ركزت تيتيانا كوستيلييفا على النطق، ولاحظت أي وقفات غير مناسبة، أو نبرة غريبة، أو كلمات جعلت الصوت يبدو وكأنه صوت جهاز كمبيوتر.
ركزت كيت ديبيلا على الأداء العاطفي، فتحققت مما إذا كان الصوت يبدو هادئًا وغنيًا بالمعلومات في نص معين، وأكثر حيوية في نص ترويجي. أما فاديم أنتيبينكو، فقد نظر في الجانب التقني، مثل سرعة الإنتاج، وجودة الصوت، وخيارات اللغة، وخيارات التصدير، ومدى سهولة دمج التسجيلات في سير عملنا.
استخدمنا أيضًا بعض الاختبارات الأكثر صعوبة بدلًا من فحص فقرة قصيرة واحدة فقط. على سبيل المثال، زودنا المولدات بنصٍّ لوسائل التواصل الاجتماعي يتضمن جملًا قصيرة وبسيطة. ثم جربنا نصًّا أطول يتضمن نسبًا مئوية وتواريخ وأسماء منتجات ومصطلحات تصوير.
في اختبار آخر، استخدمنا أسلوبين: صوت دافئ ومتفائل للإعلان، وصوت أكثر حيادية للدرس التعليمي. بدت النصوص القصيرة جيدة على معظم الأدوات، لكن النصوص الطويلة أظهرت فرقًا واضحًا. فقدت بعض الأصوات نبرتها الطبيعية، بينما حافظت أصوات أخرى على ثباتها ووضوحها من البداية إلى النهاية.
بعد ذلك، لقد اختبرنا ميزات التخصيص المتاحة في كل مولد صوت نسائي يعمل بالذكاء الاصطناعي. قمت بتغيير السرعة، ودرجة الصوت، وفترات التوقف، والانفعال، والتركيز، وأسلوب الأداء لمعرفة مدى سهولة استخدام صوت أنثوي واحد مع أنواع مختلفة من محتوى FixThePhoto. بالنسبة للأدوات التي تدعم اللغات المختلفة واستنساخ الصوت، اختبرتُ هذه الخيارات أيضًا للتأكد من إمكانية الحفاظ على ثبات الصوت نفسه عبر مقاطع الفيديو واللغات المختلفة.
أظهرت اختباراتنا أن مكتبة الأصوات الكبيرة لا تعني الكثير إذا لم تكن هناك إعدادات كافية لتشكيل طريقة قراءة الصوت للنص.
في النهاية، لم تكن النتائج كما توقعنا تمامًا. قدّم ElevenLabs و Adobe Firefly بعضًا من أفضل النتائج في مجال التعليق الصوتي الاحترافي. فقد تعاملا مع النطق والفواصل بشكل ممتاز، ومنحانا مزيدًا من التحكم في جودة الصوت.
لقد اختبرتُ هذه الأدوات في مشاريع مختلفة، وكان HeyGen هو الأنسب عندما احتجتُ إلى صوت أنثوي بتقنية الذكاء الاصطناعي وإنشاء فيديو في مكان واحد، خاصةً للمشاريع متعددة اللغات. Narakeet فقد كان فعالاً عندما احتجتُ إلى إنشاء الكثير من التعليقات الصوتية بسرعة بعدة لغات. بينما كانت Voicemod و VoiceAI و EaseUS VoiceWave أنسب لتغيير صوت موجود أو تجربة أصوات شخصيات مختلفة بدلاً من إنشاء تعليقات صوتية تقليدية.
لم نعتمد في اختيارنا للفائز على حجم مكتبة الأصوات أو جودة العروض التوضيحية فحسب، بل قمنا بتشغيل نفس النصوص العملية على كل أداة، ونظرنا في النطق والتحكم والأداء مع الكلمات الصعبة، وما إذا كان الصوت النهائي جيدًا بما يكفي لأعمال الفيديو الاحترافية.
تحققنا أيضًا من سرعة عمل كل مولد، وجودة الصوت، واللغات التي يدعمها، وتكلفته، وشروط الترخيص. أحدثت هذه الأمور فرقًا كبيرًا عند استخدامنا الفعلي للأدوات. في النهاية، لم نجد خيارنا الأمثل فحسب، بل وجدنا أيضًا المولدات الأنسب للدروس التعليمية، والإعلانات، ومواقع التواصل الاجتماعي، والفيديوهات متعددة اللغات، وغيرها من المشاريع الإبداعية.